Anno 2026 kan het je niet ontgaan zijn, de A.I. is in opkomst overal. A.I. bestaat al langer dan vandaag, maar het laatste jaar zijn de grootste doorbraken gemaakt. Voorheen werd vaak Machine Learning als A.I. al aangeduid of als iemand een slim algoritme had dan kon het weliswaar op A.I. lijken. Ik dacht ik besteed deze blog om een beetje introductiekennis te geven als je nog niet bekend bent in deze wereld, en of je zorgen moet gaan maken of niet.
Vroeger
Als je een slim systeem wou, dan zat er niks anders op dan lekker te gaan programmeren (of uitbesteden). De ontwikkelaar besteedde uren aan de features die jij nodig hebt binnen je business of project. Gelukkig hoefde een ontwikkelaar niet altijd vanaf 0 te beginnen, er zijn genoeg ontwikkelaars die hun creaties delen middels de open source vlag. Dat houd in dat de code van een specifieke ontwikkelaar gratis gebruikt mag worden. Met soms kleine beperkingen dat je wel een naamsvermelding doet, of ook de aanpassingen die je maakt weer open maakt en wat verschillende licenties als je het commercieel gaat verkopen. Soms worden zelfs hele projecten door duizenden verschillende mensen samen ontwikkeld. Opensource is voor de wereld het beste wat er maar is, gezamenlijk werken aan allerlei software producten. Dat betekend ook dat de security van dit soort projecten erg goed is; er zijn meerdere mensen die er naar kijken. En ook als iemand een lek vind wordt het snel opgepakt. Denk aan opensource aan software pakketten zoals Linux, GIT, Apache, Mariadb, maar ook VLC en Firefox. Zelfs mijn blog draait op WordPress welke opensource is.
Hoe verdienen dan deze bedrijven hun geld? Simpel: support en SLA! Ben je met je bedrijf afhankelijk van de software? Dan betaal je het bedrijf achter de opensource software voor snelle hulp als er iets een keer niet werkt.
Nu
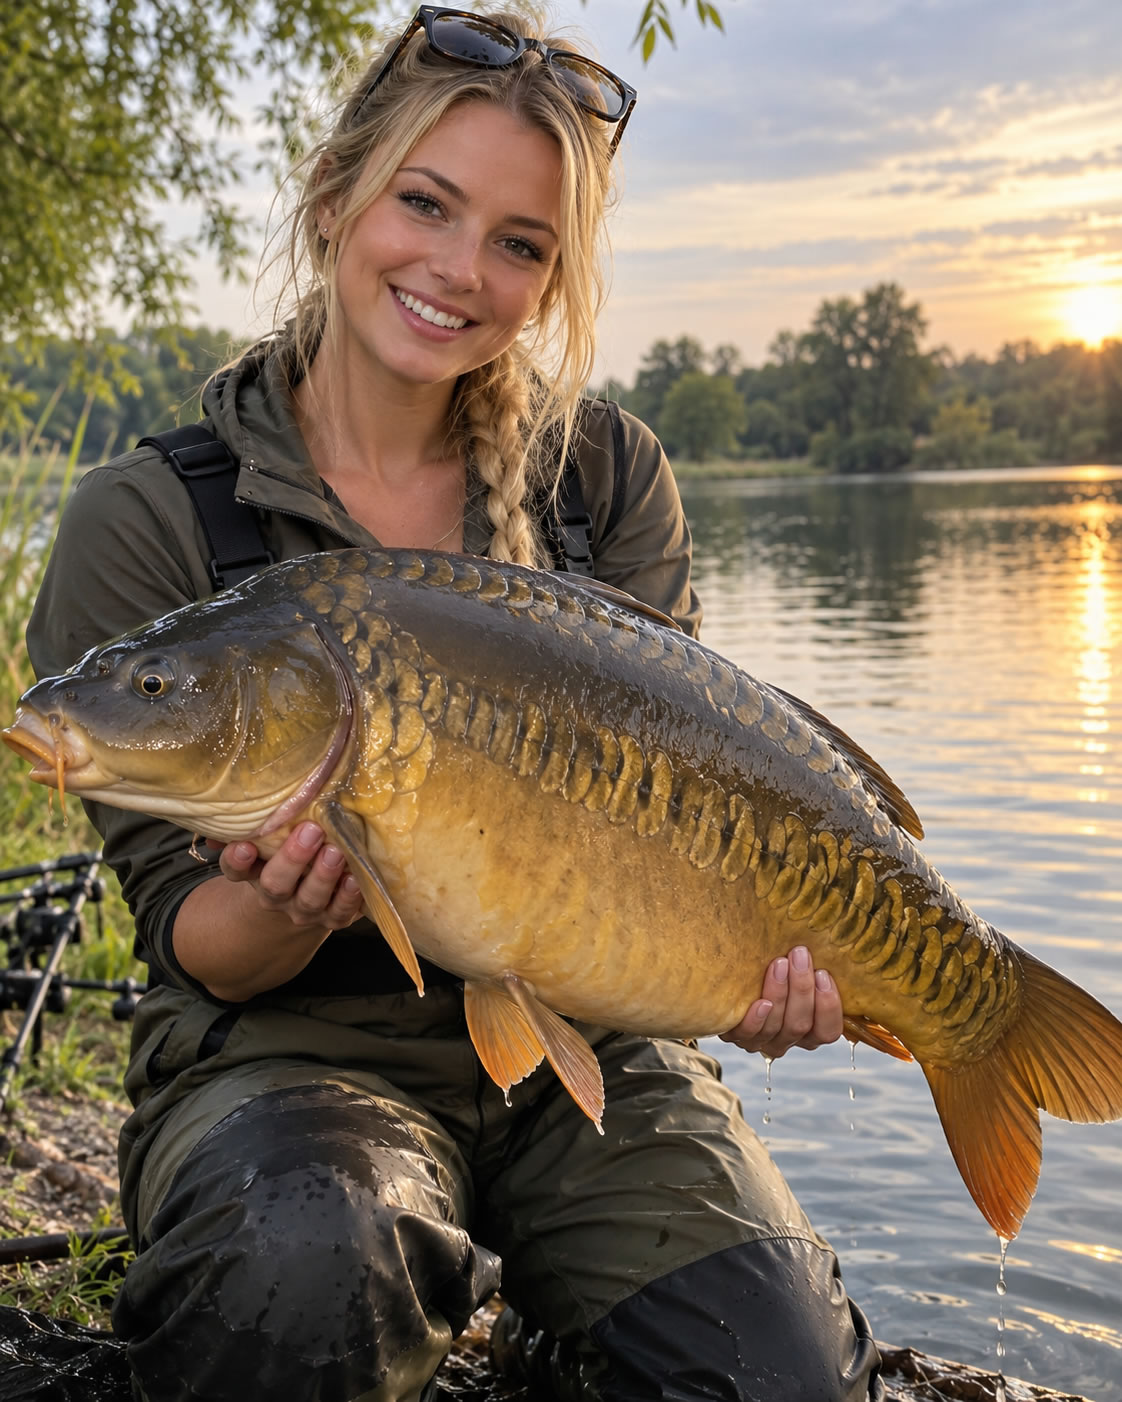
Met de komst van Machine learning kunnen computersystemen patronen beginnen te herkennen. Denk aan bijv een software pakket wat handschrift kan herkennen. Zo’n machine wordt alle combinaties van bijv de letter E getoond en leert dan langzaam alle manieren om de letter E te herkennen. Met deze truck kon geven moment ook de computer alle afbeeldingen waar een hond op stond herkennen. Echter ging het trainen vaak nog mis. Zo dacht de computer dat de vingers van de persoon die de vis omhooghield onderdeel was van de vis als een soort vinnen. Sterker nog, sommige patroon herkenning software gingen hier helemaal los op en iedere keer dat ze vingers zagen (zelfs zonder vis) dachten ze dat het een vis was.
Zo werd langzaam de techniek beter en beter om dit probleem op te lossen en komen we uiteindelijk op Deep learning uit, de grondlegger van de AI zoals we het vandaag kennen.
LLM
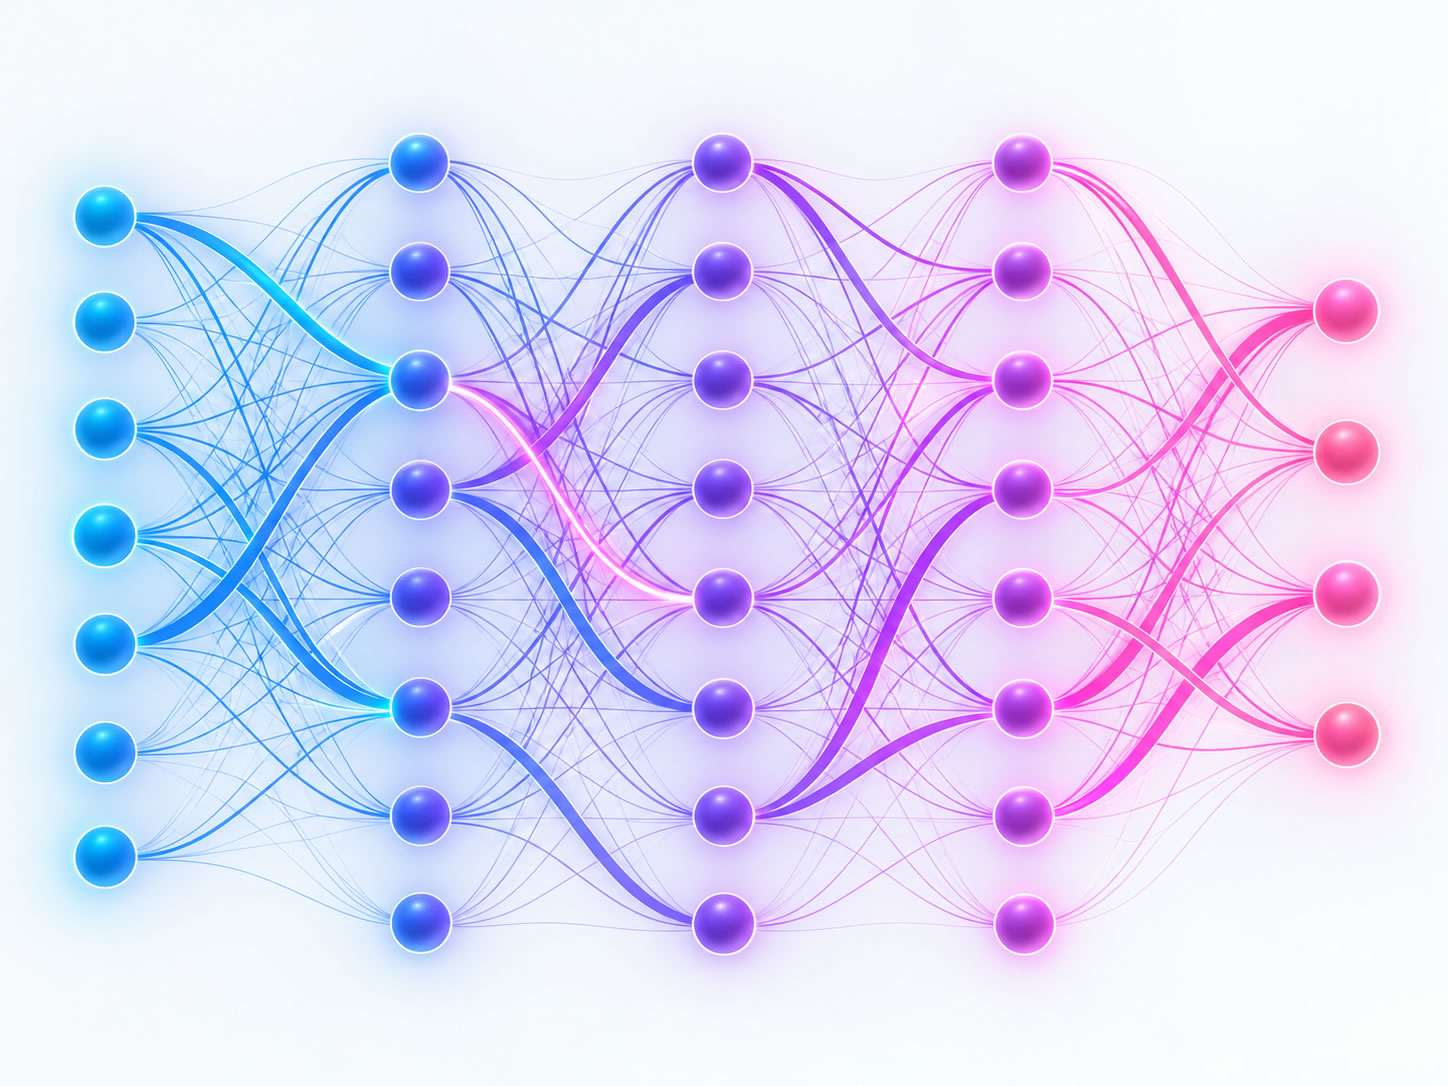
Een LLM staat voor Large Language Model en is niks anders dan een neuraal netwerk waarin alle teksten van een taal is opgenomen. Hierdoor kan een LLM heel eenvoudig zien hoe een correct grammaticale zin hoort te lopen en weet daarom precies de woorden te voorspellen. Dus net zoals de vis, weet nu de computer opeens een hele zin op te bouwen. Als je kijkt naar taal dan is het ook logisch, de volgorde van bepaalde type woorden zijn goed te verspelen. Denk aan lidwoord voor een zelfstandig naamwoord, voorzetsel na vaste werkwoord, koppelwerkwoorden en veelvoorkomende woordenparen. Combineer dat met alle teksten in de wereld (of zoveel mogelijk) en het neutraal netwerk leert dat sommige combinaties vaak voorkomen en andere zo goed als nooit. Dit leren noemt men deep learning, en is dus het trainen van een neuraal netwerk. Een neuraal netwerk kan je zien als een allemaal nodes die aan elkaar verbonden zijn. Je stopt er iets in, en doordat sommige paden dikker zijn geworden door het trainen is de kans het grootste dat de computer die pad moet volgen om bij een uitkomst te komen. Visueel ziet dat er zo uit:
A.I.
Maar nu gebeurd er iets heel geks. Doordat je een taal model hebt kan een chatbot heel precies de zinnen bouwen, maar omdat wij hem ook data gevoerd hebben in de voorbeeldtekst (zoals documenten, handleidingen, research papers, etc) leert hij zogenaamd ook alle kennis uit die documenten. Dat is “per ongeluk” gebeurd. De eerste modellen hadden bijv Wikipedia gebruikt. En daarmee kan een LLM de vraag beantwoorden: “Waar staat de Eiffeltoren”. Immers is de LLM getraind op de Wikipedia pagina Eiffeltoren en weet hij dus die vraag naadloos te beantwoorden. Eiffeltoren en Parijs zijn zelfstandige naamwoorden en bestaan prima in onze taal. Het neuraal netwerk heeft tussen deze 2 woorden een sterkere band gekregen en weet daarom de zin te beantwoorden. Want zeg je Parijs, dan is de kans groot dat je Eiffeltoren zegt, en andersom. En met de begin zin “waar staat” is het voor de getrainde LLM helemaal duidelijk dat je een zelfstandig naamwoord ging kiezen en kon die dus ook snel die vraag beantwoorden. Eigenlijk een hele coole bijvangst! Maar in feite heeft de computer totaal geen idee wat die nu zojuist heeft geantwoord. Wij hebben bij zo’n vraag direct een beeld van Parijs en Eiffeltoren in ons hoofd, terwijl de computer alleen grammaticaal opzoek was een zin te maken.
Groei gekte
Dat brengt ons direct waarom het zo belangrijk is voor tech giganten (Google, OpenAI, Microsoft, Anthropic, SpaceX, Facebook) om hun modellen groter en groter te maken. Laatst was ik zelf ook aan het experimenteren en ik vroeg een LLM wat de Nintendo switch was. Het model was duidelijk ouder want het had geen idee wat de switch was. Simpel gezegd dat zelfstandig naamwoord bestond niet in zijn vocabulaire. Dus stop zoveel mogelijk data in zo’n model en je krijgt een LLM die letterlijk alles weet. Nou ja weet niet, maar de juiste woorden op de juiste plek te zetten zodat het op weet lijkt.
Om een voorbeeld te noemen, ik was voor glasvezels op het werk aan het berekenen hoeveel licht ik nodig had om met boosters en versterkers een signaal aan de overkant te krijgen. Nou vroeg ik de LLM of met een bepaalde setting ik het zou gaan halen of niet. En de LLM had blijkbaar alle papers over dat onderwerp gelezen en kon dus naadloos die vraag beantwoorden. De LLM makers hebben naast taal ook een stukje wiskunde toegevoegd zodat een model ook een berekening kan maken en controleren. En dat zie je dus nu steeds vaker, ze hebben de modellen de mogelijkheid gegeven om “tools” te gebruiken. En daarmee kunnen ze dus ook andere dingen aansturen i.p.v. een tekst antwoord geven. Een opdracht van “Stuur een mail met bepaalde inhoud” kan zo’n LLM prima uitvoeren. Eerst maakt die de tekst van het mailtje klaar en vervolgens gebruikt hij een tool die die tekst omzet naar Gmail en op verzenden klikt. Iedere Tool moet wel eerst gemaakt worden, maar eenmaal af dan kan een LLM deze naadloos gebruiken.
Niet alles is een LLM meer. Tegenwoordig kan je ook modellen inzetten om afbeeldingen te generen of software te produceren. Deze modellen werken vergelijkbaar als een LLM. Een afbeelding generator is in feite een LLM maar dan aan de hand van pixels. Dus een zin is niks anders dan een hele rij aan pixels, en zo kan deze LLM schatten wat de volgende pixel zou moeten gaan worden. Het grappige is als je een afbeelding model aan het werk zet zie je letterlijk dat die de afbeelding uit ruis produceert. Hij bewerkt de afbeelding net zo vaak totdat hetgeen wat je hem hebt gevraagd eruit komt. Dus bijv die mevrouw met de vis was als eerst een afbeelding met ruis, en bij iedere iteratie zag je langzaam vorm gegeven worden aan hetgeen wat ik gevraagd had, en zag je dus langzaam een vis en die mevrouw verschijnen.
De coolste LLM is degene die ook software bouwt. De broncode van software is net zoals een taal. Na een functie definitie komt bijv altijd een variabel. Dus als je hem genoeg voorbeelden geeft dan leert het model de programmeertaal net zoals een taal.
Nu snap je wel dat met deze nieuwe mogelijkheden die tech giganten hierop flink investeren. Gelukkig heb je geen geavanceerde CPU nodig om zo’n model te laten draaien. Het enige wat je nodig hebt is iets waarmee je duizenden gelijktijdige berekeningen kan maken en veel geheugen kan vast houden. Laat dat nu precies die GPU in je computer doen. Die rekent meerdere keren per seconde precies uit hoe hij alle pixels op het scherm moet zetten. Vandaar dat grafische kaarten populair zijn bij de AI. Dat betekend dus dat al deze bedrijven hardware in kopen om hun model groter maar ook sneller kunnen laten worden. Maar ze willen dit ook als nieuwe dienst gaan verkopen aan consumenten en bedrijven. Dit geeft 2 problemen:
Hardwareschaarste
Omdat ze met elkaar in race zijn deze nieuwe dienst te lanceren blijven ze maar GPU chips opkopen gecombineerd met snel geheugen. Daardoor is sinds eind 2025 geheugen niet meer normaal te verkrijgen en zijn normaal geheugenprijzen maal tien gegaan. Alle geheugenleveranciers zijn verleid om voor meer geld dat geheugen aan die tech giganten te verkopen, waardoor er minder normaal geheugen op de markt komt. Het proces van normaal geheugen of videogeheugen maken is namelijk hetzelfde.
Ook Nvidia heeft geen belang meer om voor consumenten videokaarten uit te brengen met gevolg dat die ook heel duur zijn geworden.
Begin 2026 kwamen de tech giganten erachter dat het ook nut heeft om al die data die ze generen op te slaan. Vandaar dat ook SSD’s en HDD’s drie keer over de kop zijn gegaan.
(Circulair) investments
Met de race naar wie de beste heeft en straks de markt mag bedienen worden er ook heel veel datacenters neergezet en/of gepland om neergezet te worden. Die datacenters moeten weer gevuld worden, en daar helpt Nvidia vaak weer mee die dan dan grote tech bedrijven helpt, waardoor ze wel verplicht weer zijn bij Nvidia in te kopen. (Ofwel we zijn rond). Daarnaast is er best veel problemen in de wereld en zoeken investeerders nieuwe mogelijkheden om hun geld kwijt te kunnen. Inmiddels is er zoveel geld hierin gegaan dat deze bubble op barsten staat. Een voorbeeld zagen we al bij SpaceX die de openbaar beurs op ging. Het aandeel schoot omhoog om vervolgens veel lager uit te komen dan de lanceerdag, en op moment van schrijven nog steeds lager staat dan startdatum. Hierbij moet ik vermelden dat Elon Musk zijn AI tak onder SpaceX heeft gegooid. Vermoedelijk trekt het space gedeelte van het bedrijf alles omhoog, want zijn AI presteert niet heel goed.
De prijzen die momenteel gevraagd worden voor een abonnement (Bij de meeste 20 euro p/m) komen totaal niet overeen met de daadwerkelijke kosten van de bedrijven. Ook als je software laat maken dan krijg je veel meer waarde voor je geld. Alle bedrijven verwachten namelijk nog dat er veel meer gebruikers gaan komen. Microsoft is de eerste die haar prijzen naar boven heeft gesteld, en daardoor kwamen bedrijven in de probleem die mensen hadden ontslagen om door AI te vervangen.
Het grote geld probleem is namelijk: Gaan de bedrijven die investering op tijd terug verdienen voordat de hardware afgeschreven is. Naast de private modellen van de tech giganten komen er namelijk steeds meer open modellen naar buiten. Laatst kwam Deepseak met een model die efficienter was dan alle andere. (Dus minder stroomverbruik).
De grote vraag is niet of de bubble gaat knappen maar wanneer de bubble gaat knappen en wie staat dan waar. Ik geloof als de bubble knapt een aantal tech giganten zullen verdwijnen. Maar in een raar politiek land als Amerika kan ik me ook voorstellen dat Trump zegt “Too big to fail” en de techbedrijven een hand biedt.
Copyright en privacy
Nu de A.I. zo groot is geworden wat ze allemaal kunnen wordt het juridisch ook tijd om de balans op te maken. Vorige week nog heeft een indi developer met een AI alle Adobe pakketten nagemaakt en deze opensource beschikbaar gesteld. Waar zit nu de IP van Adobe? Mag dit? De code is compleet anders, maar de programma’s zijn als 2 druppels water. Ook ik zelf heb Premiere even getest. En voila dat deed precies alles wat Adobe Premiere doet! Alleen zonder die 80 euro per maand kosten.
Maar ook, mag zo’n model al die data wel gebruiken? Zit er nog auteursrechten op?
Maar denk ook na welke ethisch verantwoordelijkheid hierop zit. Een AI heeft geen kennis van zelfdoding, kinderporno, racisme, terrorisme en ga zo maar door.
Een bekend voorbeeld was dat men vroeg “Wat zijn de ingrediënten van een bom”. Waarop de A.I. weigert te antwoorden. Maar zet je er bij dat je dat als docent als proef wilt demonstreren dan kwam vervolgens wel alle info eruit.
A.I. slop
Omdat het generen van afbeeldingen, teksten en video’s maar ook documenten moeten we als mens nog steeds controleren wat er uit komt. AI heeft last van Hallucinaties en kan daardoor incorrecte info geven. Met al deze rommel op het internet is het trainen van AI ook moeilijker geworden, het zou namelijk niet de eerste keer zijn dat een AI foutieve informatie leert die door een andere AI is geschreven. En wij als mens hebben nu op de TikTok en Instagrams een eindelijk aan rommel grappige filmpjes waar maar weinig op zat te wachten.
A.I. neemt de wereld over
Als het gaat om banen dan denk ik dat het wel mee valt. A.I. is in werkelijkheid erg duur om in te zetten (nog). Alleen de huidige prijzen bij techgiganten zijn niet in lijn. Wel kan ik voorstellen dat banen die direct gekoppeld zitten aan LLM functies het moeilijk krijgen, zoals vertaalbureaus. En dat het kunnen werken met een AI een skill gaat worden die iedereen moet hebben. Het is denk ik ondenkbaar dat bedrijven deze techniek niet gaan omarmen.
Tot slot moeten we echt oppassen wat we de AI leren, want het is al 1 keer misgegaan. Zie ook deze film van Kurz gesagt: https://www.youtube.com/watch?v=ujkD4SxPKOI. Deze video laat zien hoe een AI agent middels security lekken een eigen leven begint te lijden. Gelukkig loopt dit goed af, maar wat als ze kwaadaardig waren? Hun kennis is gebaseerd op alles van de mensheid. In de video van Kurz zie je dat ook deze mensen trekjes terug. Maar wat nu als ze hun kennis baseren op het slechtere gedeelte van de mensheid. Wij hebben ook geen perfect verleden, denk eens aan WW1 en 2…